LaDM3IL
A Label Disambiguation-Based Multimodal Massive Multiple Instance Learning Approach for Immune Repertoire Classification
data: CMV 免疫组库、癌症相关受体数据
AAAI 2024(PDF 出版信息) · 作者代码
引言
面向免疫组库分类,将基因片段和氨基酸序列进行多模态融合,并用标签消歧缓解海量实例中的监督噪声。属于跨领域 MIL 方法。
方法
(1)受体编码:分别处理基因片段和氨基酸序列,获得互补特征。
(2)标签消歧:修正实例继承组库标签造成的错误监督。
(3)多模态融合:用门控注意力及张量融合聚合受体信息,输出组库与受体预测。
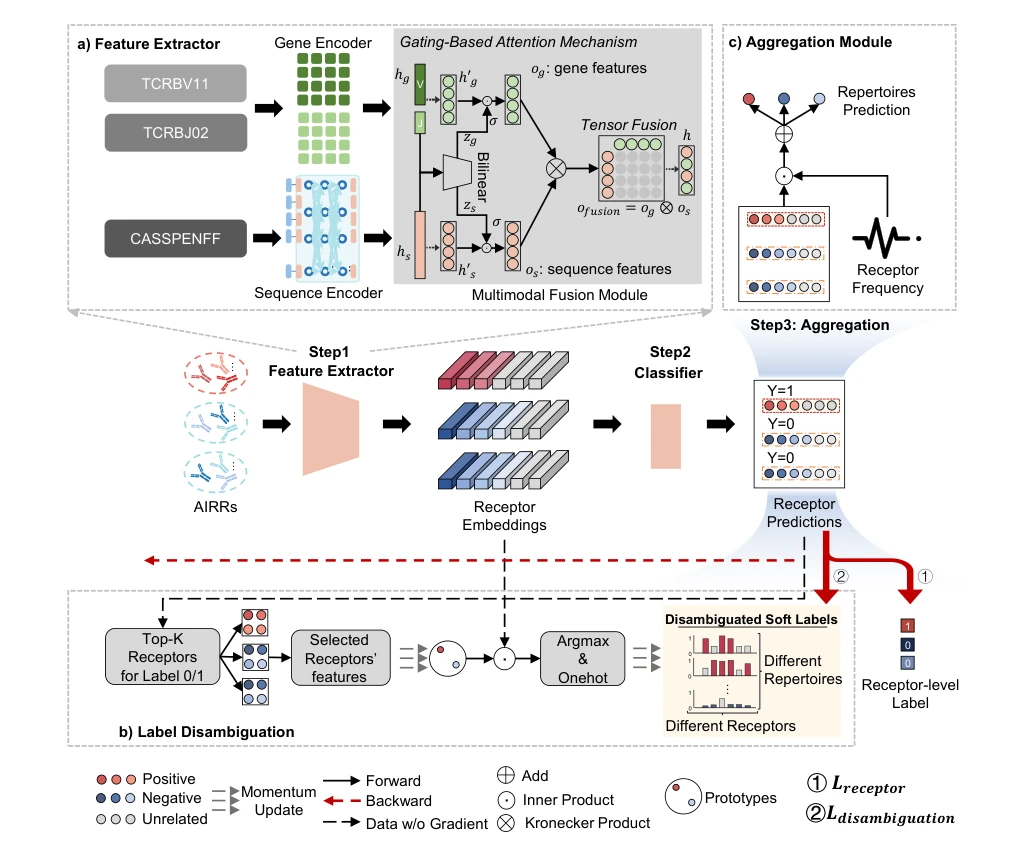
原文Figure 2,PDF 第 4 页。
实验
实验设置
CMV 使用完整信息的 684 个组库;癌症数据训练/测试受体数为 70,000/20,000,并开展五折评估。
主要结果
相对次优方法,两个任务的 AUC 分别提高 1.64 和 1.19 个百分点;输入是免疫受体序列与基因信息。
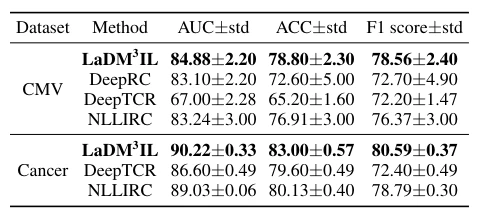
原文Table 2,PDF 第 6 页。
消融与讨论
比较 DeepRC、DeepTCR、NLLIRC,并消融标签消歧及多模态融合;癌症数据缺少 VDJ 信息,不能套用 CMV 的融合设置。
参考文献
A Label Disambiguation-Based Multimodal Massive Multiple Instance Learning Approach for Immune Repertoire Classification
AAAI 2024(PDF 出版信息) · 作者代码
本文归入相关 MIL 方法:具体研究对象见数据与实验设置。